Un soir, je laisse un agent déployer un service sur notre environnement de développement.
En local, sa correction fonctionne : le service répond 200. Une fois déployé, le même appel renvoie 503.
L’agent voit bien l’échec distant, mais il ne peut inspecter ni modifier la configuration de l’environnement. Comme il n’a la main que sur le dépôt, il retourne au code. Il corrige, redéploie, retrouve le même 503, puis recommence, très appliqué, très content de lui.
La théorie dit : « Pas compliqué, il suffit de lui mettre un garde-fou ! »
Je lui avais justement donné un critère d’arrêt : ne t’arrête que lorsque le service répond. Tant que le 503 persiste, il boucle.
Et il a bouclé parce que, de là où il regardait, il n’y avait que des 503.
Pendant une bonne partie de la soirée, il a donc consommé trois planètes de tokens sans jamais prendre de hauteur.
Le critère était clair : j’attends un 200. Mais l’agent n’avait pas la main sur ce qui fabriquait le 503.
dépôt observable et modifiable
200, tout va bien invisible et non modifiable
503 observable Le cycle, en deux minutes
Un agent ne répond pas, il boucle. La documentation le décrit en trois temps : rassembler le contexte, agir, vérifier. Il lit un fichier, en modifie un autre, lance les tests, regarde le résultat, puis recommence jusqu’à juger la tâche terminée.
Un seul détail compte pour la suite : rien dans la boucle ne compte les tours où rien ne bouge.
L’historique est là. Encore faut-il remarquer que le dernier 503 ressemble comme deux gouttes d’eau à celui d’avant. Le service ne répond toujours pas, alors l’agent repart.
Il n’a pas de rétroviseur
Vous, devant trois 503 identiques, vous avez une petite musique dans l’oreille et le petit doigt qui frétille sur la souris pour arrêter la machine.
Au troisième, j’en ai surtout marre. Je lâche le clavier et je me demande si le problème est vraiment devant mes yeux. L’agent, lui, ne se lasse pas.
Cherchez dans la boucle la garantie que cette question sera posée : « Est-ce que je prends le problème dans le bon sens ? Est-ce que je ne suis pas en train de me répéter ? » Vous ne la trouverez pas. Le modèle a l’historique sous le nez. Rien ne l’oblige à y voir un motif.
Dans notre cas, corriger encore le code n’aurait rien changé à la choucroute : le problème était une variable de configuration de l’environnement, hors du dépôt.
Chez lui, la même erreur se rejoue jusqu’à ce que quelqu’un l’arrête.
Les freins limitent la casse
Qui l’arrête, alors ?
- Le premier frein, c’est lui : il rend la main quand la tâche lui paraît finie. Sur un critère flou, ce moment peut ne jamais arriver.
- Le deuxième, c’est la coupure. En mode interactif, vous l’avez sous la main : une pression sur Échap et il s’arrête net. Un agent lâché sans personne au clavier, lui, doit être borné. C’est le rôle de
--max-turns, une option du mode non interactif (claude -p). Lorsque la limite est atteinte, l’exécution s’interrompt sur une erreur, même si le travail est inachevé. Sur mes agents de nuit, j’ajoute aussi une durée maximale : une commande interactive mal gérée peut rester silencieusement bloquée sans consommer de tours. - Le troisième est câblé dans l’outil : les contrôles de permission bloquent l’action interdite. Selon le mode d’exécution, l’agent demande une autorisation ou rend la main. Même chose lorsque la fenêtre de contexte est saturée au point que la compaction ne libère plus rien : l’outil rend la main sur une erreur plutôt que de tourner à vide.
Reprenons notre histoire. Le plafond aurait arrêté l’hémorragie de tokens. Échap aurait permis à un humain de reprendre la main. Les protections de l’outil auraient bloqué une action interdite.
La configuration fautive leur aurait pourtant échappé. Ces freins limitent les dégâts sans expliquer pourquoi l’agent n’avance plus.
« Et s’il y était presque… On le coupe aussi ? »
Et là, ça se complique.
Comment un détecteur de répétition distingue-t-il « je rejoue bêtement » de « je creuse la même piste et j’avance par petits pas » ? De l’extérieur, les deux se ressemblent : même fichier, même test rouge, même message.
Un détecteur naïf pourrait précisément couper celui qui allait aboutir au tour suivant. Il tranche à la place de l’agent sans savoir si la piste est morte.
Avec une dépendance capricieuse, deux erreurs identiques ne prouvent rien. Je relance moi-même certaines opérations. Jamais sans limite.
La répétition mérite donc une alerte, puis un diagnostic. La coupure automatique viendrait trop tôt.
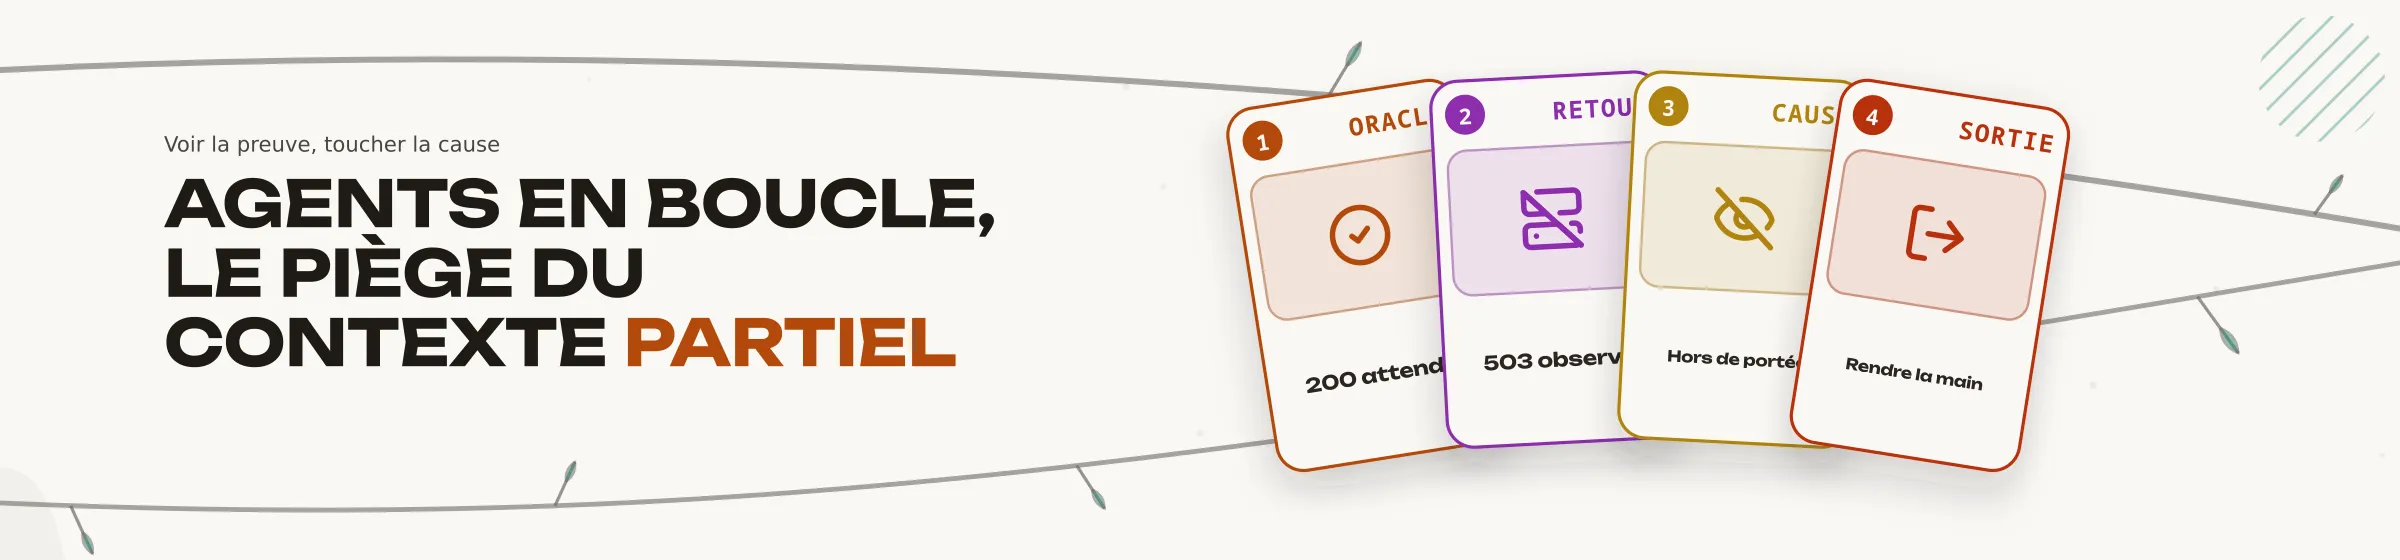
Un oracle valide, hors de portée
« Corrige le bug » est une invitation à tourner sans fin. Qu’est-ce qui prouve qu’il est corrigé ? « Les tests passent et la merge request est ouverte » donne une ligne d’arrivée que l’agent peut vérifier seul, à chaque tour : des faits et une preuve opposable.
C’est tout le sujet des oracles déterministes. Mais un oracle ne vaut que par le monde qu’il peut mesurer.
Dans notre cas, le 200 disait exactement quand le service fonctionnait. Deux questions restaient ouvertes : l’agent pouvait-il voir ce qui empêchait ce résultat, puis agir dessus une fois la cause trouvée ?
Un critère précis, vérifié par le petit bout de la lorgnette.
La réponse était non dans les deux cas. Le service lui renvoyait bien un 503, mais la configuration qui le produisait restait invisible et hors de portée.
Au troisième résultat équivalent sans information nouvelle, mes agents font désormais une pause. Ils arrêtent de modifier, rassemblent leurs hypothèses, les commandes exécutées et le dernier état observé, puis rendent la main. Ce seuil reste une règle d’exploitation, pas la preuve que la piste est morte.
Désormais, la boucle a un plafond et une porte de sortie. Une observation partielle peut toujours l’égarer. Elle ne l’emporte plus dans une nuit entière de corrections inutiles.